书接上回
虽然去年已经学习了NodeJS,并且也能用Express+Mongodb写一些后端业务,但这更多是业务逻辑上的,比如会话控制、前后端交互这些,对于NodeJS本身,社区、内置模块、进程、事件循环等等,仍是一知半解。
学习资料: Node.js-小满zs 《深入理解Node.js:核心思想与源码分析》
体系结构
NodeJS是使用C++编写的基于ChromeV8引擎,开源、跨平台的JavaScript运行环境。
现在,可以将上面这句话稍微扩展下了。
Node主要分为四大部分,Node Standard Library,Node Bindings,V8,Libuv,架构图如下:
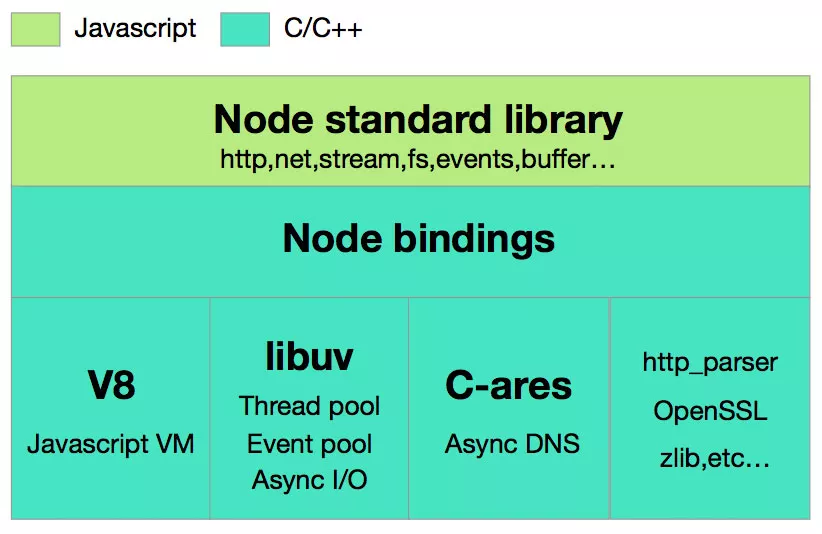
Node Standard Library 是标准库,如fs、http模块,直接提供给开发者调用。 Node Bindings 是沟通JS和C++的桥梁,封装V8和Libuv的细节,向上层提供基础API服务。 最底层是支撑Node运行的关键,由 C/C++ 实现:
- V8 Google开发的JavaScript引擎,提供JavaScript运行环境。
- Libuv 是专门为Node开发的一个封装库,提供跨平台的异步I/O能力。
- C-ares:提供了异步处理 DNS 相关的能力。
- http_parser、OpenSSL、zlib 等:提供包括 http 解析、SSL、数据压缩等其他的能力。
一些基本概念:
- NodeJS适合IO密集型应用,而不适合CPU密集型。
- Libuv提供了强大的、跨平台的异步I/O能力,使得Node可以高效地处理大量并发请求。
- Node是单线程无法利用CPU多核,易造成CPU占用率高。若要做CPU密集型工作(编解码、计算、影音处理),应使用C/C++插件或内置模块Cluster(为Node程序开启多核,并创建多个工作进程)。
Npm
Npm(Node Package Manager)是Node的包管理工具。npm 中文文档
包,即package,是一组特定功能的源码集合。管理包,即对包进行下载、安装、删除、上传操作。 使用包管理工具用于帮助开发者在自己的项目中安装、升级、移除和管理依赖项。
常用命令:
npm -v # 查看版本npm help # 列出所有命令npm -l # 列出所有命令及简单用法npm init # 初始化项目,创建package.jsonnpm install / i <包名@版本号> # 安装npm i --save / -S # 生产依赖,默认npm i --save-dev / -D # 开发依赖npm i -g # 全局安装npm i <package-name> --registry=https://registry.npmmirror.com # 指定安装源npm update # 更新依赖npm uninstall / r # 移除依赖npm prune # 清除未使用的模块npm run <script-name> # 执行脚本命令npm start # 执行start脚本命令npm search <keyword> # 关键字搜索包npm info <package-name> # 查看指定包的详细信息npm list # 列出项目所有依赖包npm ls -g # 查看全局安装的包npm outdated # 列出需要更新的包npm audit # 检查依赖项是否存在安全漏洞npm adduser # 注册npm账户npm login # 登录npm账户npm logout # 登出npm publish # 发布包npm link # 将本地模块链接到全局的node_modules目录下# npm confignpm config list # 列出npm配置信息npm config set <key> <value> [-g] # 给配置参数key设置值为value,-g配置全局.npmrcnpm config get <key> # 获取配置参数key的值npm set <key> <value> [-g] # 给配置参数key设置值为valuenpm get <key> # 获取配置参数key的值npm get registry # 查看安装源npm get userconfig # 获取用户配置文件路径npm get prefix # 获取全局node_modules路径npm config delete <key> # 删除置参数key及其值npm config list [-l] # 显示npm的所有配置参数的信息npm config edit # 编辑配置文件# npm versionnpm version patch # 2.0.0 -> 2.0.1npm version minor # 2.0.1 -> 2.1.0npm version major # 3.1.0 -> 4.0.0npm version prerelease # 1.0.0 -> 1.0.1-0, 1.0.1-0 -> 1.0.1-1npm version prepatch # 1.0.1-1 -> 1.0.2-0npm version preminor # 1.0.2-0 -> 1.1.0-0npm version premajor # 4.0.0 --> 5.0.0-0依赖管理
目前npm采用扁平化的依赖管理方式,但在npm@3之前并没有压平依赖树
node_modules└─ foo ├─ index.js ├─ package.json └─ node_modules └─ bar ├─ index.js └─ package.json尽管这样的依赖结构清晰明了,但也导致了两个严重的问题: **1、深目录:**包经常创建太深的依赖树,导致路径过长。 **2、多副本:**当不同的依赖项需要相同的包时,它们会被复制粘多次到各自的node_modules中
在linux下深目录结构也许没有问题,但在windows下有最长路径限制,可能会无法处理,导致包找不到等各种问题。 且相同的包存在多个副本,过多的占用了存储空间,这也太糟糕了,我们都知道就算是扁平化后的node_modules也还是比黑洞还重的东西(bushi)
npm@3
npm@3压平了依赖树,尽可能将依赖都放到顶层node_modules,这样就不会造成各个依赖嵌套过深,导致很多重复依赖文件等问题。
npm install时,广度优先遍历依赖树,首先处理项目根目录下的依赖,然后逐层处理每个依赖包的依赖,将依赖树尽可能拉平,直到所有依赖都被处理完毕。在处理每个依赖时,npm会检查该依赖的版本号是否符合依赖树中其他依赖的版本要求,如果不符合,则会尝试安装适合的版本,这就会导致局部的非扁平化。
解决了前两个问题,但又出现了三个新的问题: **1、幽灵依赖:**一些没有显式安装的包也能直接引用,安装包时会将该包的依赖也放到顶层node_modules,这些依赖虽然没有显式安装,但存在于顶层node_modules那么就能被引用,当卸载该包时,连通该包的依赖一起删除,若代码中引用了幽灵依赖,代码则会无法运行。 **2、版本冲突:**扁平化的策略是让不同的依赖尽可能地都放到顶层node_modules,但是node_modules的同一层级只能存在一个包的一个版本号,如果有不同的版本号就只能存在于依赖包的node_modules中,这样就会导致出现重复资源 **3、算法复杂:**拉平算法过于复杂,以至于安装新包时会有明显卡顿感,依赖结构仍然复杂且难以预料
├── package-A @1.0|── package-B @1.0├── package-C @1.0│ └── package-A @2.0│ └── package-B @2.0├── package-D @1.0│ └── package-A @2.0│ └── package-B @2.0pnpm
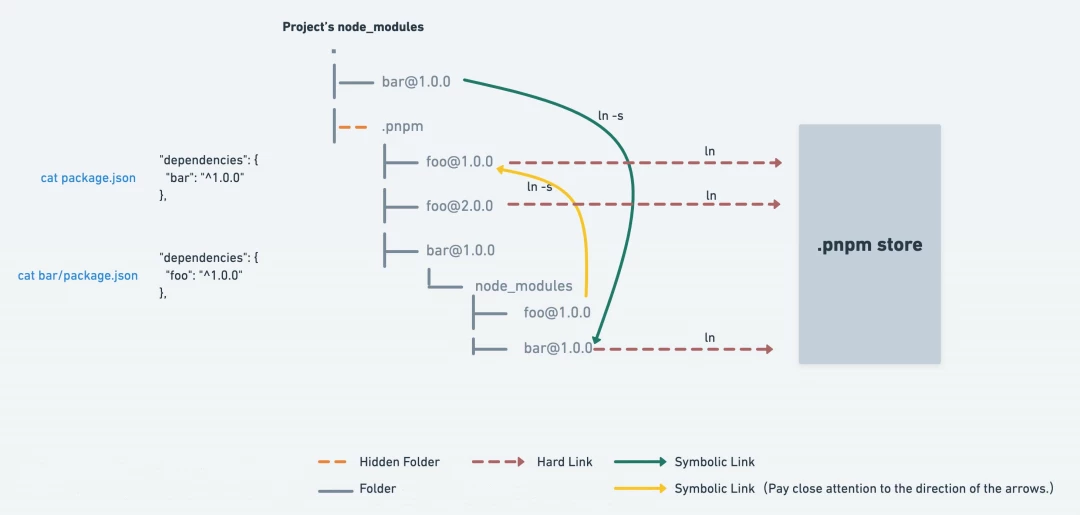
pnpm通过store + link组织依赖的目录结构
- store就是依赖的实际存储位置,当多个项目使用的是同一个依赖时,无需重复下载,极大的减少了存储空间。
pnpm store path输出store的位置 - link是指符号链接(软链接)(SymbolicLink)和硬链接(HardLink)
- SymbolicLink是一种特殊的文件,包含一条以绝对路径或者相对路径的形式指向其他文件或者目录的引用,它的存在不依赖于目标文件,如果目标文件被删除或者移动,指向目标文件的符号链接依然存在,但是它们会指向一个不复存在的文件。
- 相比于SymbolicLink,HardLink不是引用文件,而是引用inode,inode是文件系统的一种数据结构,用于描述文件系统对象。所以你即使更改目标文件的内容或位置,HardLink仍然指向目标文件,因为inode指向该文件。
试着执行pnpm add vue
现在node_modules有两个主要的文件,.pnpm和vue。
- .pnpm将所有依赖放在同一层文件夹中,每个包都可以通过
.pnpm/<name>@<version>/node_modules/<name>找到,然后通过硬链接(HardLink)的方式在store中引用依赖文件。 - vue是一个符号链接(SymbolicLink),Node会找到vue的真实位置
.pnpm/vue@3.4.5/node_modules/vue。
├── .modules.yaml├── .pnpm│ ├── lock.yaml│ ├── picocolors@1.0.0│ │ └── node_modules│ ├── node_modules│ │ ├── .bin│ │ └── picocolors -> ../picocolors@1.0.0/node_modules/picocolors│ └── react@18.2.0│ └── node_modules└── vue -> .pnpm/vue@3.4.5/node_modules/vue顶层node_modules下不会存在未显式安装的依赖,也就不存在幽灵依赖问题。 不同版本的不同依赖都在.pnpm文件夹下扁平化存在。
install后续
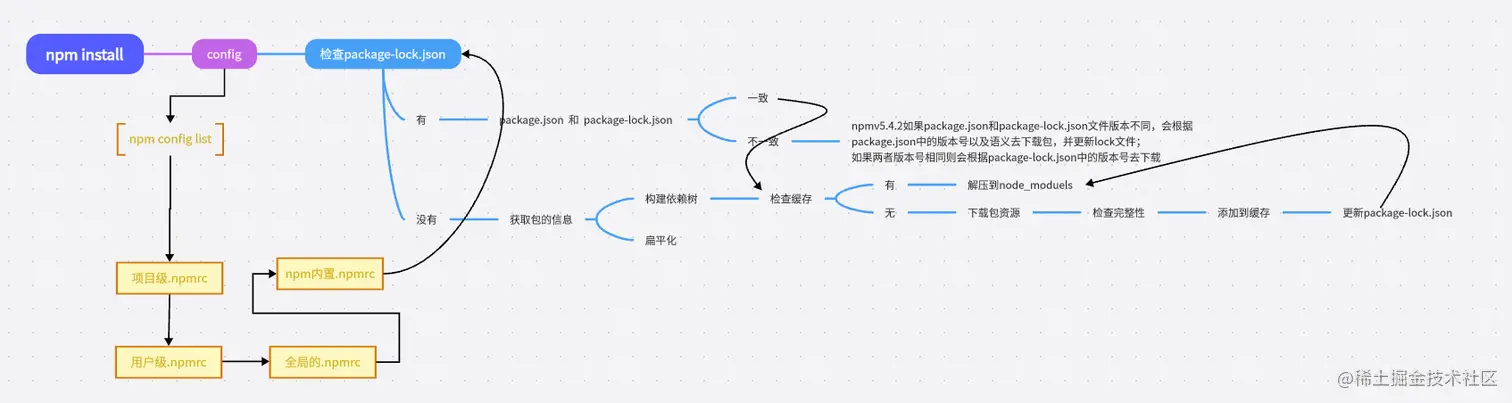
.npmrc是npm运行时配置文件,一台电脑中有多个.npmrc,按如下顺序读取
- 项目配置文件:在项目根目录中新建一个.npmrc。
- 用户配置文件:
npm config get userconfig获取该文件的位置,一般位于当前用户目录。 - 全局配置文件:位于
$PREFIX/etc/npmrc,使用npm config get prefix获取$PREFIX。不曾配置过全局文件,则该文件不存在。 - npm内嵌配置文件:npm内置的配置,一般用不到
registry=http://registry.npmjs.org/# 定义npm的registry,即npm的包下载源
proxy=http://proxy.example.com:8080/# 定义npm的代理服务器,用于访问网络
https-proxy=http://proxy.example.com:8080/# 定义npm的https代理服务器,用于访问网络
strict-ssl=true# 是否在SSL证书验证错误时退出
cafile=/path/to/cafile.pem# 定义自定义CA证书文件的路径
user-agent=npm/{npm-version} node/{node-version} {platform}# 自定义请求头中的User-Agent
save=true# 安装包时是否自动保存到package.json的dependencies中
save-dev=true# 安装包时是否自动保存到package.json的devDependencies中
save-exact=true# 安装包时是否精确保存版本号
engine-strict=true# 是否在安装时检查依赖的node和npm版本是否符合要求
scripts-prepend-node-path=true# 是否在运行脚本时自动将node的路径添加到PATH环境变量中
package-lock
npm@5引入了package-lock.json用于锁定版本并记录依赖树详细信息。
package.json单纯记录本项目的依赖, 而没有记录依赖的依赖信息, 并且依赖之间的版本号又没有明确固定, 无法保证依赖环境一致。package-lock.json用于解决该问题, 它会详细的记录项目依赖的版本号及依赖的依赖的版本号。
{ "dependencies": { "express": "^4.18.0" }}向上标号^意为向后(新)兼容依赖,package.json文件只能锁定大版本,也就是版本号的第一位,并不能锁定后面的小版本,指定版本为^4.18.0,实际下载的可能是最新的4.18.2,向后兼容大多数情况下是没有问题的。但为了稳定性考虑,应该锁定版本号,package-lock.json就提供了这样的功能。
npm install xxx@x.x.x更新依赖,package和package-lock也随之更新
version 当前包的版本号resolved 当前包的下载地址integrity 用于验证包的完整性dev 是否为开发依赖包bin 当前包中可执行文件的路径和名称engines 当前包所依赖的Node.js版本范围npm使用包的name + version + integrity信息生成唯一key,使用该key可以在index-v5(缓存索引目录)下找对应的缓存记录,若存在,则去content-v2目录下找到缓存,将对应的二进制文件解压到node_modeules
windows下缓存路径默认在%user%\AppData\Roaming\npm-cache
npm run
npm run会读取package.json中scripts对应的脚本命令。 npm scripts 使用指南--阮一峰
"scripts": { "dev": "vite"},所有可执行脚本都位于项目的node_modules/.bin目录中,包通过package.json中的bin配置命令文件,而node会自动向.bin目录注入.sh、.cmd、.ps1三个可执行脚本。
"bin": { "vite": "bin/vite.js"},可执行脚本的查找顺序:当前项目node_modules -> 全局node_modules -> 环境变量 -> 报错。
每当执行npm run,就会自动新建一个Shell,在这个Shell里面执行指定的脚本命令。因此,只要是Shell可以运行的命令,就可以写在 npm 脚本里面。npm run会将node_modules/.bin加入当前Shell的PATH变量,执行结束后,再将PATH变量恢复原样。
npm run还有pre和post两个钩子,将其加到原本的命令名前形成新的命令配置,pre表示在该命令之前执行,post则是在该命令之后执行。
"scripts": { "dev": "node index.js", "predev": "node pre.js", "postdev": "node post.js"},npx
npm@5.2新增了npx功能,npx 使用教程--阮一峰
npx用于调用项目内部安装的模块。它会到node_modules/.bin路径和环境变量$PATH中,检查命令是否存在并调用。
相比于新增scripts脚本并使用npm run调用,npx更加方便快捷。
# 调用vite命令npm run dev # "dev": "vite"npx vitenpx还可以避免全局安装模块,只要 npx 调用的模块无法在本地发现,就会下载同名模块的最新版本(也可以指定版本),使用后自动删除,避免了占用磁盘空间以及版本更新不及时等问题。
两个参数:
--no-install强制使用本地模块。--ignore-existing忽略本地的同名模块。
使用指定版本的node执行代码:
npx node@0.12.8 index.js npx会临时下载node模块,并使用它运行js代码。
npm init
npm init 用于初始化一个新的项目,生成一个 package.json 文件,包含项目的基本信息。
在 npx 出现后,init 命令也可以创建一些特定结构的包。就像 npm init vite 这样。
npm init <initializer> # npm create 是其别名<initializer> 实际上所指的包名是 create-<initializer>,npm 会自动下载该包,并执行 package.json 中 bin 字段对应的脚本。例如 create-vite。
"bin": { "create-vite": "index.js", "cva": "index.js"},另外,并非空目录下才能使用 npm init,它实际上是添加性操作,所以已有的字段和值都会被保留下来。
若是指定了初始化程序,init 行为就得看包的实现了。@eslint/create-config 就是增量式的修改。可以很方便地通过 npm 命令在项目中初始化一些配置。
npm私服
为什么需要npm私服:
- 内部使用的组件、模块不能公开,但仍然需要npm进行依赖管理。
- 组件化,模块化,工程化,团队建设,都需要私有源配合。
- 确保npm服务快速、稳定,减少开发人员和CI服务器的重复下载量并提高下载速度。
- 控制npm模块质量和安全,对于下载、发布npm包有对应的权限管理。
npm私服搭建工具:Verdaccio、Nexus、sinopia
Verdaccio为例,安装模块npm i verdaccio -g,直接运行verdaccio命令即可。
之后执行命令时带上私有源--registry http://localhost:4873,或新建项目级的.npmrc指定npm源。
其它常用命令:
verdaccio --listen 9999 # 指定端口npm adduser --registry http://localhost:4873/ # 创建账户npm publish --registry http://localhost:4873/ # 发布包npm i --registry http://localhost:4873 # 安装时指定源模块化
以往的笔记:
CommonJS
- 支持引入内置模块例如 http os fs child_process 等nodejs内置模块。
- 支持引入第三方模块express md5 koa 等。
- 支持引入自己编写的模块 ./ ../ 等。
- 支持引入addon C++扩展模块 .node文件。
const fs = require('node:fs'); // 导入核心模块const express = require('express'); // 导入 node_modules 目录下的模块const myModule = require('./myModule.js'); // 导入相对路径下的模块const nodeModule = require('./myModule.node'); // 导入扩展模块module.exports = { name: chuckle}exports.a = 1在cjs中也可以使用esm的import()动态引入模块。
import('./data.json', { assert: { type: 'json' }}).then(data => { console.log(data.default) // { name: 'data' }})ESM
import { stat, exists, readFile } from 'fs';const name = '张三';export const age = 18;export default name;import { age } from './index.js';import name from './index.js';引入json文件需增加断言并且指定类型json。
import data from './data.json' assert { type: "json" };console.log(data)引入addon C++扩展模块 .node文件需要特殊处理。
import { createRequire } from 'module';const require = createRequire(import.meta.url);const addon = require('./addon.node');CJS 与 ESM 的区别:
- CJS是基于运行时的同步加载,esm是基于编译时的异步加载。
- CJS是可以修改值的,esm值不可修改(只读的)。
- CJS无法tree shaking,esm支持tree shaking。
- CJS中顶层的this指向这个模块本身,而ES6中顶层this指向undefined。
CJS源码
lib\internal\modules是Node@18实现模块化的源码,其中cjs\loader.js是实现CommonJS的主要源码。
参考: Node.js 模块系统源码探微 nodejs部分源码解析--小满
每个文件都被视为一个独立的模块。模块被加载时,都会初始化为 Module 对象的实例,模块对外暴露自己的 exports 属性作为使用接口。
function Module(id = '', parent) { // 模块 id,通常为模块的绝对路径 this.id = id; this.path = path.dirname(id); // exports setOwnProperty(this, 'exports', {}); // 当前模块调用者 moduleParentCache.set(this, parent); updateChildren(parent, this, false); this.filename = null; // 模块是否加载完成 this.loaded = false; // 当前模块所引用的模块 this.children = []; // ......}require函数
Module._load 实现了加载模块的主要逻辑
Module.prototype.require = function(id) { // 验证 id 是否为字符串类型且非空 validateString(id, 'id'); // 如果 id 为空字符串,抛出一个错误,要求 id 为非空字符串 if (id === '') { throw new ERR_INVALID_ARG_VALUE('id', id, 'must be a non-empty string'); } // requireDepth记载模块加载的深度,在达到一定深度时进行一些特殊处理 // 自增表示当前模块的加载深度增加了一个层次 requireDepth++; try { // 调用 Module._load 方法加载指定的模块,isMain 参数设为 false // isMain用于在模块加载过程中区分出主模块和其他模块 return Module._load(id, this, /* isMain */ false); } finally { // 自减表示当前模块的加载深度减少了一个层次 requireDepth--; }};Module._load
步骤的简单说明:
- Module._load首先处理内建模块,直接返回其exports对象
- 解析出模块的全路径,如果找到缓存的模块,且已被加载,则直接返回该模块缓存的exports
- 尝试加载没有以 'node:' 开头导入的内建模块,两次加载内建模块的核心都是loadBuiltinModule函数
- 获取该模块的缓存(已缓存但未加载),或创建一个新的 Module 实例
- 调用module.load加载模块
- 最后返回加载好的模块的exports对象
Module._load = function(request, parent, isMain) {  let relResolveCacheIdentifier;  // 优化相同目录下懒加载的模块的加载过程  if (parent) {    // .....  }
  // 内建模块处理  // 如果模块请求以 'node:' 开头,表示模块为内建模块  if (StringPrototypeStartsWith(request, 'node:')) {    // Slice 'node:' prefix    const id = StringPrototypeSlice(request, 5);
    const module = loadBuiltinModule(id, request);    if (!module?.canBeRequiredByUsers) {      throw new ERR_UNKNOWN_BUILTIN_MODULE(request);    }    // 加载内建模块并返回其 exports    return module.exports;  }
  // 解析出模块的全路径  const filename = Module._resolveFilename(request, parent, isMain);
  // 如果找到缓存的模块,如果已被加载,则直接返回该模块缓存的exports  // 否则将其标记为已加载,后续再去处理缓存的加载  const cachedModule = Module._cache[filename];  if (cachedModule !== undefined) {    // 更新父模块的子模块列表    updateChildren(parent, cachedModule, true);    // 检查模块是否已经加载    if (!cachedModule.loaded) {      // 如果模块尚未加载      // 获取缓存的 CommonJS 模块的解析结果对象      const parseCachedModule = cjsParseCache.get(cachedModule);      // 如果解析结果对象不存在,或者解析结果对象已经加载过      if (!parseCachedModule || parseCachedModule.loaded)        // 返回处理循环 require 的情况的导出对象        return getExportsForCircularRequire(cachedModule);      // 将解析结果对象标记为已加载      parseCachedModule.loaded = true;    } else {      return cachedModule.exports;    }  }
  // 尝试加载没有以 'node:' 开头导入的内建模块  const mod = loadBuiltinModule(filename, request);  if (mod?.canBeRequiredByUsers &&      BuiltinModule.canBeRequiredWithoutScheme(filename)) {    return mod.exports;  }
  // 获取模块的缓存,或创建一个新的 Module 实例  const module = cachedModule || new Module(filename, parent);
  // 如果是主模块,则标记主模块  if (isMain) {    setOwnProperty(process, 'mainModule', module);    setOwnProperty(module.require, 'main', process.mainModule);    module.id = '.';  }
  // 通知监视模式有关模块状态的变化  reportModuleToWatchMode(filename);
  // 模块实例缓存  Module._cache[filename] = module;  if (parent !== undefined) {    relativeResolveCache[relResolveCacheIdentifier] = filename;  }
  let threw = true;  try {    // 调用module.load加载模块    module.load(filename);    threw = false;  } finally {    // 进行一些清理工作    // ......  }
  // 返回导出对象  return module.exports;};
模块的缓存、加载策略:
- 缓存命中,且已被加载过,直接返回exports
- 内建模块,直接返回其exports
- 已缓存但未加载的模块、使用文件或第三方代码生成的模块,加载后并缓存,下次同样的访问就会去使用缓存而不是重新加载
module.load
module.load分析模块的后缀,并将模块交给特定的文件后缀名解析函数处理
针对不同后缀的模块,Node.js 的加载方式是不同的
Module.prototype.load = function(filename) {  // 调试信息,输出加载模块的文件名和模块的标识符  debug('load %j for module %j', filename, this.id);
  // 确保模块是未被加载过的  assert(!this.loaded);  // 设置模块的文件名和路径列表  this.filename = filename;  this.paths = Module._nodeModulePaths(path.dirname(filename));
  // 寻找并确定文件名的扩展名  const extension = findLongestRegisteredExtension(filename);  // allow .mjs to be overridden  // 如果文件名以 '.mjs' 结尾,并且没有针对 '.mjs' 的扩展处理函数,抛出错误  if (StringPrototypeEndsWith(filename, '.mjs') && !Module._extensions['.mjs'])    throw new ERR_REQUIRE_ESM(filename, true);
  // 执行特定文件后缀名解析函数 如 js / json / node  Module._extensions[extension](this, filename);  // 表示该模块加载成功  this.loaded = true;
  // ... esm 模块的支持};
处理.json
JSON文件的内容会被解析为JS对象,并赋值给module.exports,从而能够被其他模块引用。
Module._extensions['.json'] = function(module, filename) {  // 读取文件内容,返回utf8字符串  const content = fs.readFileSync(filename, 'utf8');
  // 存在安全策略时,进行内容完整性验证  if (policy?.manifest) {    // 获取文件的模块 URL    const moduleURL = pathToFileURL(filename);    // 进行内容完整性验证    policy.manifest.assertIntegrity(moduleURL, content);  }
  try {    // stripBOM移除字符串中的BOM(字节顺序标记)    // JSONParse解析JSON字符串为JS对象    // setOwnProperty设置module的exports属性为该JS对象    // 以前的代码是这么做的module.exports = JSONParse(stripBOM(content));    setOwnProperty(module, 'exports', JSONParse(stripBOM(content)));  } catch (err) {    // 如果解析失败,将文件名和错误信息拼接后抛出错误    err.message = filename + ': ' + err.message;    throw err;  }};
处理.node
.node 文件是一种由 C/C++ 实现的原生模块,通过 process.dlopen() 读取。
Module._extensions['.node'] = function(module, filename) { // 存在安全策略时,进行内容完整性验证 if (policy?.manifest) { const content = fs.readFileSync(filename); const moduleURL = pathToFileURL(filename); policy.manifest.assertIntegrity(moduleURL, content); } // 使用 process.dlopen 方法加载模块 return process.dlopen(module, path.toNamespacedPath(filename));};process.dlopen() 实际上调用了 C++ 写的 DLOpen()。
SetMethod(context, target, "dlopen", binding::DLOpen);DLOpen() 又调用了 uv_dlopen(),uv_dlopen是 libuv 库提供的函数,unix下调用dlopen接口,而在win下调用LoadLibraryExW接口,作用是在运行时打开一个共享库文件(插件),并返回一个句柄,使得程序能够调用该库中的函数或使用其中的符号。
bool DLib::Open() { int ret = uv_dlopen(filename_.c_str(), &lib_); // ......}void DLOpen(const FunctionCallbackInfo<Value>& args) { // ...... env->TryLoadAddon(*filename, flags, [&](DLib* dlib) { // ...... const bool is_opened = dlib->Open(); // ...... if (!is_opened) { std::string errmsg = dlib->errmsg_.c_str(); dlib->Close(); } } // ......}处理.js
如果缓存过这个模块就直接从缓存中读取,否则使用fs读取文件,并且判断如果是cjs但是type为module就报错,并且从父模块读取详细的行号进行报错,如果没问题就调用 _compile加载js模块
Module._extensions['.js'] = function(module, filename) { // If already analyzed the source, then it will be cached. // 从cjsParseCache中获取已经解析过的模块源码 // const cjsParseCache = new SafeWeakMap(); const cached = cjsParseCache.get(module); let content; // 保存源码内容的变量 // 如果已缓存,则直接使用缓存的源码。 if (cached?.source) { content = cached.source; cached.source = undefined; } else { // 否则,fs读取文件内容 content = fs.readFileSync(filename, 'utf8'); } // 如果是.js文件,还需进行type检查,cjs或mjs就直接交给_compile处理 if (StringPrototypeEndsWith(filename, '.js')) { const pkg = readPackageScope(filename); // Function require shouldn't be used in ES modules. // 如果package.json中type为module,则抛出错误,因为ESM不应该使用require if (pkg?.data?.type === 'module') { const parent = moduleParentCache.get(module); const parentPath = parent?.filename; const packageJsonPath = path.resolve(pkg.path, 'package.json'); const usesEsm = hasEsmSyntax(content); const err = new ERR_REQUIRE_ESM(filename, usesEsm, parentPath, packageJsonPath); // Attempt to reconstruct the parent require frame. // 如果抛出了错误,它还会尝试重构父模块的 require 调用堆栈, // 以提供更详细的错误信息。它会读取父模块的源代码,并根据错误的行号和列号, // 在源代码中找到相应位置的代码行,并将其作为错误信息的一部分展示出来。 if (Module._cache[parentPath]) { let parentSource; try { parentSource = fs.readFileSync(parentPath, 'utf8'); } catch { // Continue regardless of error. } if (parentSource) { const errLine = StringPrototypeSplit( StringPrototypeSlice(err.stack, StringPrototypeIndexOf( err.stack, ' at ')), '\n', 1)[0]; const { 1: line, 2: col } = RegExpPrototypeExec(/(\d+):(\d+)\)/, errLine) || []; if (line && col) { const srcLine = StringPrototypeSplit(parentSource, '\n')[line - 1]; const frame = `${parentPath}:${line}\n${srcLine}\n${ StringPrototypeRepeat(' ', col - 1)}^\n`; setArrowMessage(err, frame); } } } // 抛出错误 throw err; } } // 调用_compile继续处理js模块的加载 module._compile(content, filename);};module._compile
module._compile调用wrapSafe函数,向模块内部注入__dirname等公告变量,并将模块内容包装为一个安全的可执行的全局上下文函数,然后通过Reflect.apply调用该函数,将需要的5个参数传入,最后返回执行完的结果
Module.prototype._compile = function(content, filename) {  // 如果启用了策略,则获取模块的 URL 和相关信息  let moduleURL;  let redirects;  const manifest = policy?.manifest;  if (manifest) {    // 将模块文件名转换为URL格式    moduleURL = pathToFileURL(filename);    // redirects是一个URL映射表,用于处理模块依赖关系    redirects = manifest.getDependencyMapper(moduleURL);    // manifest则是一个安全策略对象,用于检测模块的完整性和安全性    manifest.assertIntegrity(moduleURL, content);  }  // 向模块内部注入公共变量 __dirname / __filename / module / exports / require  // 并将模块内容包装为一个安全的可执行函数  // compiledWrapper得到一个可执行的全局上下文函数  const compiledWrapper = wrapSafe(filename, content, this);
  let inspectorWrapper = null;  // ... 对于 Inspector 调试模式的支持
  const dirname = path.dirname(filename);  const require = makeRequireFunction(this, redirects);  let result;  const exports = this.exports;  const thisValue = exports;  const module = this;  if (requireDepth === 0) statCache = new SafeMap();  if (inspectorWrapper) {    // 调用compiledWrapper,将需要的5个参数传入,最后返回执行完的结果    result = inspectorWrapper(compiledWrapper, thisValue, exports,                              require, module, filename, dirname);  } else {    // Reflect.apply调用compiledWrapper,将需要的5个参数传入,最后返回执行完的结果    result = ReflectApply(compiledWrapper, thisValue,                          [exports, require, module, filename, dirname]);  }  hasLoadedAnyUserCJSModule = true;  if (requireDepth === 0) statCache = null;  return result;};
wrapSafe
wrapSafe将模块内容包装为一个安全的可执行函数,并对ESM的import()函数提供支持,用来动态加载模块,最后返回一个可执行的全局上下文函数
function wrapSafe(filename, content, cjsModuleInstance) {  // 如果已经打过补丁(重要的也是这部分)  if (patched) {    // wrap函数:将模块内容包装为一个安全的可执行函数    const wrapper = Module.wrap(content);    // 创建 vm.Script 对象,表示可执行JS代码的node虚拟机    const script = new Script(wrapper, {      filename,      lineOffset: 0,      // 在CJS中支持ESM的import(),用来动态加载模块      importModuleDynamically: async (specifier, _, importAssertions) => {        const loader = asyncESM.esmLoader;        return loader.import(specifier, normalizeReferrerURL(filename),                             importAssertions);      },    });
    // Cache the source map for the module if present.    // 如果模块包含源映射,缓存源映射信息    if (script.sourceMapURL) {      maybeCacheSourceMap(filename, content, this, false, undefined, script.sourceMapURL);    }
    // vm.runInThisContext此方法用于创建一个独立的沙箱运行空间    // code 内的代码可以访问外部的 global 对象,但是不能访问其他变量    // 返回一个可执行的全局上下文函数    return script.runInThisContext({      displayErrors: true,    });  }
  // 没有打过补丁  try {    // 调用 internalCompileFunction 函数将模块内容编译为一个函数    const result = internalCompileFunction(content,      // 传递给编译的函数的参数列表      [      'exports',      'require',      'module',      '__filename',      '__dirname',    ], {      filename,      // 在CJS中支持ESM的import(),用来动态加载模块      importModuleDynamically(specifier, _, importAssertions) {        const loader = asyncESM.esmLoader;        return loader.import(specifier, normalizeReferrerURL(filename),                             importAssertions);      },    });
    // Cache the source map for the module if present.    // 如果模块包含源映射,缓存源映射信息    if (result.sourceMapURL) {      maybeCacheSourceMap(filename, content, this, false, undefined, result.sourceMapURL);    }
    // 返回一个可执行的全局上下文函数    return result.function;  } catch (err) {    if (process.mainModule === cjsModuleInstance)      enrichCJSError(err, content);    throw err;  }}
wrap函数用于将模块内容包装为一个安全的可执行函数,采用了字符串拼接的方式,使用需要Node公共变量为参数的函数包裹模块内容
let wrap = function(script) { return Module.wrapper[0] + script + Module.wrapper[1];};const wrapper = [ '(function (exports, require, module, __filename, __dirname) { ', '\n});',];总结
CJS模块化核心是require的实现:
- 读取需要引入的文件
- 读取到文件后,将代码封装成一个可执行函数
- 通过 vm.runInThisContext 将其转为 JS 代码(沙箱)
- 代码调用
全局变量&API
Node中使用global关键字定义全局变量,就像浏览器中使用window一样。
不同环境下,全局变量的关键字不同,为了统一,ECMA2020 提出了globalThis全局变量,会自动适配环境。
全局变量在任何一个模块都能够访问到,但require是动态的,还要注意代码执行顺序。
global.a = 1;globalThis.b = 2;console.log(a, b) // 1 2Node还有一些内置的全局变量,__dirname、__filename、exports、require、module
// 当前模块的所在目录的绝对路径console.log(__dirname) // c:\***\***// 当前模块文件的绝对路径,包括文件名和文件扩展名console.log(__filename) // c:\***\***\index.js**全局API:**由于Node中没有DOM和BOM,除了这些API,其他的ECMA的API基本都能用,此外Node还有一些内置的全局API,如process、Buffer
like DOM
Node环境没有DOM和BOM,但可以借助jsdom等第三方库构建一个DOM,并实现类似的DOM API操作,这对于SSR、爬虫等领域是非常有用的
const fs = require('fs')const path = require('path')const { JSDOM } = require('jsdom')
// 读取html文件的内容const content = fs.readFileSync(path.join(__dirname, 'index.html'), 'utf-8')// 构建dom对象const dom = new JSDOM(content)// 全局挂载API方便使用globalThis.window = dom.windowglobalThis.document= dom.window.document// dom操作document.querySelector('#app').innerHTML = 'hello world'// 覆写html文件fs.writeFileSync(path.join(__dirname, 'index.html'), dom.serialize())
渲染模式与SEO
上面这种服务端处理dom、渲染数据、构建html页面的操作就是SSR(Server-Side Rendering)
而Vue、React等单页应用(SPA)则是在客户端完成dom操作、数据渲染,即是CSR(Client-Side Rendering)
非常通透的一篇文章:极速加载还是绝佳SEO?探索CSR、SSR、SSG等渲染模式的优劣对决
SEO: 搜索引擎优化(Search Engine Optimization)。是一种利用搜索引擎规则,提高网站在搜索引擎内自然排名的技术。对大多数搜索引擎,不识别JavaScript 内容,只识别 HTML 内容。
**MPA:**多页应用(multiple page application)。各个页面相互独立,需要单独维护多个 html 页面,每个请求都直接返回 html,对 SEO 友好,但切换页面就会重载,将带来巨大的重启性能消耗,切换页面比较慢。 **SPA:**单页面应用(single page application)。动态重写当前的页面来与用户交互,而不需要重新加载整个页面。单页应用做到了前后端分离,后端只负责处理数据提供接口,页面逻辑和页面渲染都交给了前端。CSR、SSR、SSG 都是基于 SPA。
**CSR:**客户端渲染(Client Side Render)。渲染过程全部交给浏览器进行处理,服务器不参与任何渲染。页面初始加载的HTML文档中无内容,需要下载执行JS文件,由浏览器动态生成页面,并通过JS进行页面交互事件与状态管理。 **SSR:**服务端渲染(Server Side Render)。DOM树在服务端生成,而后返回给前端。即当前页面的内容是服务器生成好一次性给到浏览器的进行渲染的。
**SSG:**静态站点生成(Static Site Generation)。与SSR的原理非常类似,但不同之处在于HTML文件是预先生成的,而不是在服务器实时生成。 **ISR:**增量式网站渲染(Incremental Static Regeneration)。结合了SSG和SSR的优势,静态页面的构建仍然是在构建时完成的,类似于SSG。但ISR允许某些页面在构建后仍保持动态,并在用户首次访问时进行服务端渲染。一旦渲染完成,生成的静态页面被缓存,并在后续的请求中被直接提供,以提高性能和响应速度。 **同构:**SSR和CSR的结合,在服务器端执行一次,用于实现服务器端渲染(首屏直出),在客户端再执行一次,用于接管页面交互(绑定事件),核心解决SEO和首屏渲染慢的问题。采用同构思想的框架:Nuxt.js(基于Vue)、Next.js(基于React)。
POSIX
**POSIX:**可移植操作系统接口(Portable Operating System Interface of UNIX),是IEEE为要在各种UNIX操作系统上运行的软件而定义的一系列API标准的总称,以方便软件程序在不同操作系统上的移植。
Windows也遵守这套标准,但又没有完全遵守,在路径表示等方面就不同于POSIX。 Windows路径分隔符为反斜杠(\),而POSIX使用的正斜杠(/)。
Path模块
Path用于对路径的操作
常用方法:
sep获取当前系统的路径分隔符basename获取路径的基础名称dirname获取路径的目录名extname获取文件的扩展名join拼接路径,使用当前系统的分隔符resolve解析路径,返回绝对路径parse解析路径并返回对象format从对象中解析出路径,和 parse 相反isAbsolute判断是否为绝对路径relative获取 from 到 to 的相对路径normalize规范化路径,将不符合规范的路径经过格式化转换为标准路径
const path = require('path')
// 1、sep 获取当前系统的路径分隔符console.log(path.sep); // \
// 2、basename 获取路径的基础名称console.log(path.basename(__filename)); // index.js
// 3、dirname 获取路径的目录名console.log(path.dirname(__filename)); // c:\chuckle\qx\NodeJS-new\path
// 4、extname 获取文件的扩展名console.log(path.extname(__filename)); // .jsconsole.log(path.extname("/a/b/index.min.js")); // .js 多个.只会获取最后一个console.log(path.extname("/a/b/index")); // 没有扩展名返回空字符串
// 5、join 拼接路径,使用当前系统的分隔符console.log(path.join(__dirname, 'index.js')); // c:\chuckle\qx\NodeJS-new\path\index.js// 支持路径操作符号console.log(path.join('a', 'b', '../')); // a\// 如果连接后的路径字符长度为0,则返回 '.',表示当前工作目录console.log(path.join('')) // '.'
// 6、resolve 解析路径,返回绝对路径// 返回工作目录的绝对路径+相对路径console.log(path.resolve('a', 'b')); // C:\chuckle\qx\NodeJS-new\a\b// 多个绝对路径,返回最后一个,并忽略前面的相对路径console.log(path.resolve('a', '/b', '/c', 'd')); // C:\c\d// 如果解析后的路径字符长度为0,则返回工作目录的绝对路径console.log(path.resolve('')); // C:\chuckle\qx\NodeJS-new// 常用console.log(path.resolve(__dirname, 'index.js')); // c:\chuckle\qx\NodeJS-new\path\index.js
// 7、parse 解析路径并返回对象console.log(path.parse(__filename));// {//   root: 'c:\\',//   dir: 'c:\\chuckle\\qx\\NodeJS-new\\path',//   base: 'index.js',//   ext: '.js',//   name: 'index'// }// ┌──────────────────┬────────────┐// │          dir     │    base    │// ├──────┬           ├──────┬─────┤// │ root │           │ name │ ext │// "  /    foo/bar/baz/ index  .js "
// 8、format 从对象中解析出路径,和 parse 相反console.log(path.format(path.parse(__filename))); // c:\chuckle\qx\NodeJS-new\path\index.js
// 9、isAbsolute 判断是否为绝对路径console.log(path.isAbsolute('/foo')); // trueconsole.log(path.isAbsolute('\\foo')); // trueconsole.log(path.isAbsolute('C:/foo')); // trueconsole.log(path.isAbsolute('./a')); // false
// 10、relative 获取 from 到 to 的相对路径console.log(path.relative('/foo/bar/baz', '/foo/bar/dir/file.js')) // ..\dir\file.js// from 或 to 任何一方为空,则使用当前工作目录代替其空路径console.log(path.relative('', '/foo/bar/dir/file.js')) // ..\..\..\foo\bar\dir\file.jsconsole.log(path.relative('/foo/bar/dir/file.js', '')) // ..\..\..\..\chuckle\qx\NodeJS-new
// 11、normalize 规范化路径,将不符合规范的路径经过格式化转换为标准路径console.log(path.normalize('c:\\a\\b\\c\\index.js')); // c:\a\b\c\index.jsconsole.log(path.normalize('c:\\\\\a/\\\\b\\\c/\\/index.js')); // c:\a\b\c\index.jsconsole.log(path.normalize('c:/a/../b/c')); // c:\b\c
windows兼容正反斜线作为路径分隔符,但POSIX只允许使用正斜线(/),path模块提供了兼容方法
// 若需要在POSIX中处理windows路径,使用 win32 进行兼容console.log(path.win32.basename('c:\\a\\b\\c\\index.js')); // index.js// 也可以在windows下使用 posix 规范console.log(path.posix.basename('c:\\a\\b\\c\\index.js')); // c:\a\b\c\index.js,posix无法处理windows路径console.log(path.posix.basename('c:/a/b/c/index.js')); // index.jsOS
os模块用于与操作系统进行交互
常用方法:
platform获取当前系统平台type获取当前系统名称release获取当前系统版本号version获取当前系统版本名称EOL返回操作系统的换行符,"\n" 或 "\r\n"arch获取当前系统的 CPU 架构constants返回操作系统的常量,如错误码、信号码等homedir获取当前用户的主目录cpus获取CPU的线程以及详细信息networkInterfaces获取网络接口列表freemem获取系统空闲内存,单位字节totalmem获取系统总内存,单位字节hostname获取主机名uptime获取系统正常运行时间,单位秒userInfo获取当前用户信息loadavg获取系统平均负载,数组包含 1、5、15 分钟的平均负载tmpdir获取系统临时目录endianness获取系统字节序getPriority(pid)获取进程优先级setPriority(pid, priority)设置进程优先级
// 1、platform 获取当前系统平台console.log(os.platform()); // win32// type Platform = 'aix' | 'android' | 'darwin' | 'freebsd' | 'haiku' | 'linux' | 'openbsd' | 'sunos' | 'win32' | 'cygwin' | 'netbsd';
// 2、type 获取当前系统名称console.log(os.type()); // Windows_NT// returns `'Linux'` on Linux, `'Darwin'` on macOS, and `'Windows_NT'` on Windows.
// 3、release 获取当前系统版本号console.log(os.release()); // 10.0.19044
// 4、version 获取当前系统版本名称console.log(os.version()); // Windows 10 Pro
// 5、EOL 返回操作系统的换行符,"\n" 或 "\r\n"console.log(JSON.stringify(os.EOL)); // "\r\n"
// 6、arch 获取当前系统的 CPU 架构console.log(os.arch()); // x64//  ‘arm’, ‘arm64’, ‘ia32’, ‘mips’, ‘mipsel’, ‘ppc’, ‘ppc64’, ‘riscv64’, ‘s390’, ‘s390x’, ‘x64’ 等。
// 7、constants 返回操作系统的常量,如错误码、信号码等console.log(os.constants); // { UV_UDP_REUSEADDR: 4, ... }
// 8、homedir 获取当前用户的主目录console.log(os.homedir()); // C:\Users\64507// 底层原理是通过环境变量获取,USERPROFILE 或 HOME// > printenv USERPROFILE
// 9、cpus 获取CPU的线程以及详细信息,返回数组,元素个数为线程数(逻辑处理器个数)console.log(os.cpus()); // [ { model: 'AMD Ryzen 7 5800U with Radeon Graphics ... } ]console.log(os.cpus().length); // 16 线程数// {//   model: 'AMD Ryzen 7 5800U with Radeon Graphics', // CPU型号//   speed: 1896, // CPU速度,以MHz或GHz为单位//   times: { // CPU时间(毫秒)//     user: 3473453, // 用户态时间//     nice: 0, // 低优先级用户态时间//     sys: 5935453, // 系统态时间//     idle: 437847828, // 空闲时间//     irq: 704953 // 硬中断时间//   }// },
// 10、networkInterfaces 获取网络接口列表console.log(os.networkInterfaces()); // { '本地连接* 1': [ { address: '127.0.0.1', ... } ] }// {//   address: '127.0.0.1', // IP地址//   netmask: '255.0.0.0', // 子网掩码//   family: 'IPv4', // IP协议版本//   mac: '00:00:00:00:00:00', // MAC地址//   internal: true, // 是否为内部地址//   cidr: '127.0.0.1/8' // CIDR表示法// }
// 11、freemem 获取系统空闲内存,单位字节console.log(os.freemem()); // 4641640448
// 12、totalmem 获取系统总内存,单位字节console.log(os.totalmem()); // 16442781696
// 13、hostname 获取主机名console.log(os.hostname()); // DESKTOP-3JQKQ0O
// 14、uptime 获取系统正常运行时间,单位秒console.log(os.uptime()); // 1017.283
// 15、userInfo 获取当前用户信息console.log(os.userInfo()); // { uid: -1, gid: -1, username: '64507', homedir: 'C:\\Users\\64507', shell: null }
// 16、loadavg 获取系统平均负载,数组包含 1、5、15 分钟的平均负载console.log(os.loadavg()); // [ 0, 0, 0 ]// 它只在Linux和macOS上返回有意义的值。
// 17、tmpdir 获取系统临时目录console.log(os.tmpdir()); // C:\Users\64507\AppData\Local\Temp
// 18、endianness 获取系统字节序console.log(os.endianness()); // LE// 取决于Node是用Big Endian还是Little Endian编译的。
// 19、getPriority(pid) 获取进程优先级console.log(os.getPriority(0)); // 0
// 20、setPriority(pid, priority) 设置进程优先级console.log(os.setPriority(0, 10)); // undefined
获取到设备和操作系统信息后,方便程序进行兼容处理。不同系统的shell命令差异较大,就需要程序对系统类型进行判断。
const childProcess = require('child_process')const os = require('os')
// 兼容不同系统的打开浏览器命令const open = (url) => {  const cmd = {    darwin: 'open',    win32: 'start',    linux: 'xdg-open'  }  childProcess.exec(`${cmd[os.platform()]} ${url}`)}
open('https://www.baidu.com')
非阻塞
我们常说Node是单进程单线程的应用,这里的单线程,意思是只有一个线程用于解释执行JS代码,而Node进程还是包含有多个线程的,其它的线程用于处理I/O操作等任务
JS总是一种同步(阻塞)的单线程语言,但是我们可以通过编程使JS异步运行。
在理解Node的非阻塞前,或许应该先复习下浏览器环境下的同步与异步:Promise异步编程--同步与异步
JS引擎维护了一个调用栈,当该调用栈被一个JS脚本(task)占用时,无法再执行其它脚本。
console.log("task开始")setTimeout(() => { console.log("setTimeout")}, 1000)while (true) { }console.log("task结束")上面的代码只会输出"task开始",然后被死循环阻塞。
下面是一个伪代码:
create(server) // 创建一个web服务parse(query) // 解析请求获取参数read(data) // I/O操作,从系统磁盘读取文件内容send(result) // 将结果返回给用户同步状态下的执行流程:
- create(server)创建一个web服务,初始化调用栈,启动一个线程,等待请求
- 当服务器接收到了一个请求,脚本task入栈,线程开始工作
- parse(query)入栈,耗时1ms完成解析请求,执行完后出栈
- 然后read(data)入栈,耗时50ms读取文件完成,出栈
- 接着send(result)入栈,耗时1ms将结果返回,出栈
- 最后脚本task出栈,清空调用栈
整个过程耗时52ms,看起来是很短,但如果同时有一千个请求,每个请求的task排队入栈,整个服务的响应将会变得非常慢。
Node要想在单线程上更快得处理请求,实现高并发,就需要将I/O等耗时任务尽快出栈。 将特定的耗时任务作为异步任务,交给Node中其它特定的线程去处理,最后再将任务的回调入栈处理,显然是个好办法,实际上浏览器环境也是这么做的。
何时处理回调,如何处理各种不同的异步任务、优先级,这需要一个管理者。 事件循环就充当了这么一个角色。
事件循环
事件循环是Node处理非阻塞I/O操作的机制。
参考: 一张图带你搞懂Node事件循环 从源码了解 Node.js 事件循环
Node是事件驱动的,从设计模式上来说,类似观察者模式。 在事件驱动模型中,会生成一个主循环来监听事件,当检测到事件时触发回调函数。
事件循环是基于libuv的,它提供了跨平台的异步I/O能力,当然,对于底层的C++实现,现在谈还过早了。
一图流:
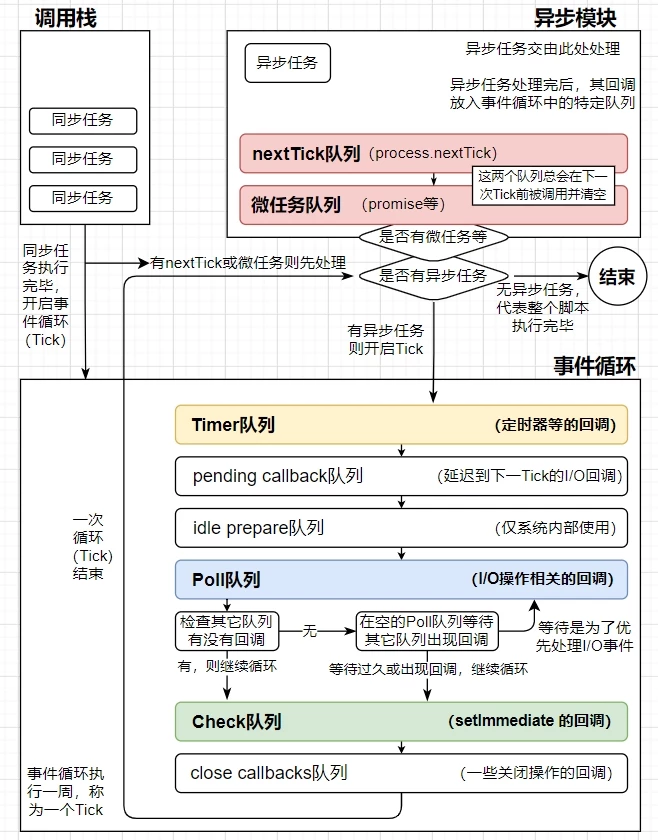
JS的执行过程:
- 同步任务进入调用栈,异步任务交给异步模块处理
- 异步任务处理完后,将回调交给事件循环中对应的队列
- 同步任务执行完毕,开启事件循环。
事件循环流程:
- 检查并清空nextTick和微任务队列
- 然后依次清空Timer->poll队列
- 接着判断其它队列是否有回调待执行,即队列是否为空
- 若其它队列为空,则在该空的poll队列等待,这是为了优先处理I/O事件。(若等待时间过长,也会继续循环)
- 若其它队列不为空了,则继续循环,往下依次清空队列
- 一次Tick结束后,检查是否有还有异步任务,有则开启下一次Tick
总之,事件循环就是在同步任务都结束后,循环处理异步回调,并优先处理I/O事件,直到所有异步任务都结束。
setTimeout(() => {  console.log("setTimeout1")}, 2000)
Promise.resolve().then(()=>{  console.log('promise')})
process.nextTick(()=>{  console.log('nextTick')})
setTimeout(() => {  console.log("setTimeout2")}, 1000)
setImmediate(()=>{  console.log('setImmediate')})
setTimeout(() => {  console.log("setTimeout3")}, 0)
fs.writeFile('./test.txt', 'test', () => {  console.log('writeFile')})
运行结果:
// nextTick// promise// setTimeout3// setImmediate// writeFile// setTimeout2// setTimeout1process
process 提供有关当前 Node.js 进程的信息,并对其进行控制的全局API
进程计算机系统进行资源分配和调度的基本单位,是操作系统结构的基础,是线程的容器
1、异步:nextTick(fn)
console.log('1');process.nextTick(function(){ console.log('2');});console.log('3');// 1 3 22、获取命令行参数:argv
返回一个数组,第一个元素是 node.exe 的路径,第二个元素是当前执行的 js 文件的路径,其余的元素是命令行参数,但不包括 node specific 参数
console.log(process.argv)// 第一个元素是 node.exe 的路径,第二个元素是当前执行的 js 文件的路径,其余的元素是命令行参数// [// 'C:\\Program Files\\nodejs\\node.exe', // node.exe 的路径// 'c:\\chuckle\\qx\\NodeJS-new\\process\\index.js', // 当前执行的 js 文件的路径// '--version' // 命令行参数// ]console.log(process.argv.includes('--version') ? '1.0.0' : null) // node index.js --version3、获取node specific参数:execArgv
返回数组,只包含 node specific 参数
// node --harmony .\execArgv.js -a -b -cconsole.log(process.execArgv);// [ '--harmony' ]console.log('------------------');console.log(process.argv);// [// 'C:\\Program Files\\nodejs\\node.exe',// 'C:\\chuckle\\qx\\NodeJS-new\\process\\execArgv.js',// '-a',// '-b',// '-c'// ]4、获取和切换工作目录:
cwd() 获取当前工作目录
chdir(dir) 切换工作目录
// 取当前工作目录console.log(process.cwd()) // C:\chuckle\qx\NodeJS-new 获取当前工作目录console.log(path.resolve()) // C:\chuckle\qx\NodeJS-new 获取当前工作目录console.log(__dirname) // c:\chuckle\qx\NodeJS-new\process 获取当前文件所在的目录// 切换工作目录console.log(process.chdir('..')) // 修改当前工作目录console.log(process.cwd()) // C:\chuckle\qx5、当前进程信息:
pid 获取当前进程的 pid
ppid 当前进程对应的父进程的 pid
title 获取当前进程的名称,可修改,用于区分Node进程
console.log(process.pid) // 45736console.log(process.ppid) // 37716
console.log(process.title) // 管理员: C:\windows\System32\WindowsPowerShell\v1.0\powershell.exeprocess.title = 'node'console.log(process.title) // node
6、进程运行和资源占用情况:
uptime() 获取当前进程运行的时间,单位秒
memoryUsage() 获取内存使用情况
cpuUsage([previousValue]) CPU使用时间耗时,单位为微秒
hrtime([time]) 一般用于做性能基准测试
console.log(process.uptime()) // 0.0367208
console.log(process.memoryUsage())// {//   rss: 36507648, // 常驻内存,物理内存存量//   heapTotal: 6369280, // V8给分配的堆内存总量//   heapUsed: 5690504, // 已使用的堆内存//   external: 429451, // 外部内存使用量 c、c++ 使用的//   arrayBuffers: 17378 // ArrayBuffer 的总内存// }console.log(os.freemem()); // 获取系统空闲内存console.log(os.totalmem()); // 获取系统总内存
const startUsage = process.cpuUsage();const now = Date.now();while (Date.now() - now < 500);console.log(process.cpuUsage(startUsage)); // { user: 500000, system: 0 }// user表示用户程序代码运行占用的时间,system表示系统占用时间// 如果当前进程占用多个内核来执行任务,那么数值会比实际感知的要大
7、node可执行程序相关信息:
execPath node可执行程序的绝对路径
version 获取当前Node版本
versions 获取Node及其依赖库的版本
release 当前node发行版本的相关信息
config 当前node版本编译时的参数
console.log(process.execPath) // C:\Program Files\nodejs\node.execonsole.log(process.version) // v18.12.1console.log(process.versions)// {// node: '18.12.1',// v8: '10.2.154.15-node.12',// ......// }console.log(process.release)// {// name: 'node',// lts: 'Hydrogen',// ......// }console.log(process.config) // [......]8、进程运行环境:
arch 获取 CPU 架构
platform 获取操作系统平台
console.log(process.arch) // x64console.log(os.arch()) // x64
console.log(process.platform) // win32console.log(os.platform()) // win329、警告信息:emitWarning(warning)
process.emitWarning('warning!');// 可以给警告信息加个名字,便于分类process.emitWarning('warning!', 'CustomWarning');// 也可以传入Error对象const myWarning = new Error('Warning!');myWarning.name = 'CustomWarning';process.emitWarning(myWarning);// 监听warningprocess.on('warning', (warning) => { console.warn(warning.name); // 'CustomWarning' console.warn(warning.message); // 'warning!' console.warn(warning.stack); // CustomWarning: Warning! at Object.<anonymous> ......});10、终止进程:
exit([exitCode]) 立即退出进程,
exitCode 设置退出码,然后等进程自动退出
exit() 往往是不保险的,如果在执行exit之前,还有异步操作没有执行完,那么这些异步操作将不会执行,如果程序出现异常,必须退出不可,可以抛出一个未被捕获的error,来终止进程
process.exit(1) // 退出当前进程,退出码为1process.exitCode = 1 // 退出码为111、向进程发送信号:kill(pid, [signal])
kill 不同于它的名字,虽然可以用来退出进程,但实际作用是向进程发送特定信号signal-events
Windows不支持信号(但部分信号也能使用)
退出进程的信号:
SIGTERM默认信号,可监听,退出之前重置终端模式SIGINT键盘Ctrl+C,可监听,如果安装了监听器,其默认行为将被删除(Node将不再退出)SIGKILL它会无条件地终止Node,无法监听
其它信号:
0可以发送来测试进程是否存在,如果进程存在则没影响,如果进程不存在则抛出错误
process.kill(process.pid); // 默认是 SIGTERM 信号,杀死进程,退出之前重置终端模式process.kill(process.pid, 'SIGINT') // Ctrl+C 退出进程process.kill(process.pid, 0)
// 例子// 从标准输入开始读取,因此进程不会退出。process.stdin.resume();
process.on('SIGINT', () => {  console.log('不能使用 Ctrl + C 退出了');});
// 使用单个函数处理多个信号function handle(signal) {  console.log(`Received ${signal}`);}
process.on('SIGINT', handle);process.on('SIGTERM', handle);
进程事件监听
on(event, handle) 监听进程事件
Node中有许多进程事件:
1、beforeExit
当 Node 清空其事件循环并且没有额外的工作时,会触发该事件,表示Node进程将要退出
其监听器回调将 exitCode 值作为唯一的参数传入
对于导致显式终止的条件,例如调用 exit() 或未捕获的异常,不会触发该事件
setTimeout(() => { console.log("setTimeout1")}, 2000)process.exitCode = 1// 两秒后,事件循环清空,触发beforeExit事件process.on('beforeExit', (code) => { console.log(code) // 1})注册在该事件上的监听器可以进行异步的调用,从而使 Node 进程继续
process.on('beforeExit', (code) => { setTimeout(() => { console.log("setTimeout") }, 2000)})// setTimeout// setTimeout// ......上面的代码中,事件循环被清空,触发beforeExit,表示Node进程将要退出,但回调中又使用异步任务(setTimeout)激活了事件循环,于是2秒后执行异步任务的回调,然后清空事件循环,事件循环一被清空又触发beforeExit,循环往复
2、exit
当 Node 进程退出时触发,即使是exit()显式终止
其监听器回调将 exitCode 值作为唯一的参数传入
beforeExit 先于 exit 触发
setTimeout(() => {  console.log("setTimeout1")}, 2000)process.exitCode = 1
process.on('exit', (code) => {  console.log('exit', code)  setTimeout(() => {    console.log("setTimeout2")  }, 2000)})
process.on('beforeExit', (code) => {  console.log('beforeExit', code)})
执行结果: exit表示Node进程的结束,Node不会再等回调中的异步任务执行完毕,调用栈清空后直接退出进程
// setTimeout1// beforeExit 1// exit 13、disconnect
如果 Node进程是使用 IPC 通道生成的(子进程),当 IPC 通道关闭时将触发该事件
4、warning
每当 Node 触发进程警告时,都会触发该事件
回调接收一个warning对象,有三个属性
- name
警告的名称 - message
警告描述 - stack
代码中触发警告的位置的堆栈跟踪
setTimeout(() => { const err = new Error('错误信息') err.name = 'CustomError' process.emitWarning(err)}, 2000)process.on('warning', (warning) => { console.log(warning.name) console.log(warning.message) console.log(warning.stack)})// (node:40184) CustomError: 错误信息// (Use `node --trace-warnings ...` to show where the warning was created)// CustomError// 错误信息// CustomError: 错误信息// at Timeout._onTimeout (c:\chuckle\qx\NodeJS-new\process\进程事件.js:21:15)// at listOnTimeout (node:internal/timers:564:17)// at process.processTimers (node:internal/timers:507:7)5、信号事件:
process.on() 还可以监听信号事件,本质上也属于进程事件,Windows不支持信号(但部分信号也能使用),但Node提供了 kill 方法模拟发送信号
当 Node 进程收到信号时,将触发信号事件
setTimeout(() => { process.kill(process.pid) // 默认信号为SIGTERM console.log('kill') // 在win上不会执行}, 2000)// 在windows上会直接退出进程,而不会监听到SIGTERM信号process.on('SIGTERM', (signal) => { console.log(`Received ${signal}`)})标准输入输出
stdin 标准输入流,它是程序的输入源
stdout 标准输出流,它是程序的输出源
stderr 标准错误流,用于由程序发出的错误信息和诊断
在Node.js中使用stdout、stdin和stderr的方法
标准流:当程序执行时,它们在程序和环境之间互连输入和输出通信通道 可读流Readable、可写流Writable
process.stdin.setEncoding('utf8'); // 设置编码格式process.stdin.resume() // 开启输入流// 通过监听data事件来处理输入。每当用户输入一些数据时,就会触发data事件process.stdin.on("data", data => { // 监听输入 process.stdout.write(`data: ${data.toString()}`) // 输出输入 // process.stdin.pause() // 暂停输入流})// 当有可从流中读取的数据或已到达流的末尾时,则将触发 readable 事件。// 表明流有新的信息。如果数据可用,则 stream.read() 将返回该数据。process.stdin.on('readable', () => { let chunk; while ((chunk = process.stdin.read()) !== null) { process.stdout.write(`readable: ${chunk}`); }});// 当标准输入流结束时触发,即输入流中没有更多数据可供读取时,win上不一定会触发process.stdin.on('end', () => { console.log('输入结束');});上述程序会创建一个事件监听器来监听命令行中数据输入,并将用户的输入打印到终端。
可以通过监听输入流的 data 或 readable 事件获取输入流的数据
通过process.stdout.write()将数据写入标准输出流,比console.log更底层、更灵活
- 不会自动添加换行符
- 不会添加额外的空格
- 不可以直接输出对象
process.stdout.write(`hello `) // 需要手动添加空格process.stdout.write(`world${os.EOL}`) // 需要手动添加换行符// hello worldconsole.log("hello")console.log("world") // console.log会自动在输出末尾添加换行符// hello// world// console.log会自动在不同的输出之间添加空格console.log("hello", "world")// hello worldconst obj = { name: 'obj' }process.stdout.write(JSON.stringify(obj) + os.EOL) // 需要手动将对象转换为字符串console.log(obj) // console.log可以直接输出对象// {"name":"obj"}readline
readline 模块用于一次一行地读取可读流(如 process.stdin)中的数据
通过 readline.createInterface(options) 构造 readline.Interface 类的实例,每个实例都与单个 input 可读流和单个 output 可写流相关联
1. input <stream.Readable> 要监听的可读流2. output <stream.Writable> 要写入 readline 数据的可写流3. completer <Function> 可选的用于Tab制表符自动补全的函数4. terminal <boolean> 如果 input 和 output 流应该被视为终端,并且写入了 ANSI/VT100 转义码,则为 true。默认值:在实例化时检查 output 流上的 isTTY。5. history <string[]> 历史行的初始列表。仅当 terminal 由用户或内部的 output 检查设置为 true 时,此选项才有意义,否则历史缓存机制根本不会初始化。默认值:[]。6. historySize <number> 保留的最大历史行数。要禁用历史记录,则将此值设置为 0。仅当 terminal 由用户或内部的 output 检查设置为 true 时,此选项才有意义,否则历史缓存机制根本不会初始化。默认值:30。7. removeHistoryDuplicates <boolean> 如果为 true,则不会将重复的历史记录添加到历史记录中。默认值:false。8. prompt <string> 要使用的提示字符串。默认值:'> '。9. crlfDelay <number> 读取行时要使用的延迟毫秒数,用于确定输入行何时结束。默认值:100。10. escapeCodeTimeout <number> 读取转义序列时要使用的超时毫秒数11. tabSize <number> 一个制表符等于的空格数(最小为 1)。默认值:8。12. signal <AbortSignal> 允许使用中止信号关闭接口。中止信号将在内部调用接口上的 close。Interface常用实例方法:
question(query[, options], (answer)={})向用户提问,并将答案作为回调的首个参数传回write(data)向output流写入字符串close()关闭Interface实例,放弃对 input 和 output 流的控制,触发 close 事件,但不会立即阻止其它由Interface实例触发的事件,如linepause()暂停 input 流resume()恢复 input 流prompt([preserveCursor])为用户提供新行,恢复input流,并等待用户输入。preserveCursor 如果为 true,则防止光标位置重置为 0setPrompt(prompt)设置prompt提示字符串,prompt为字符串,当调用prompt()时,会将prompt字符串写入output流getPrompt()获取当前prompt提示字符串clearLine(dir)清除当前行,dir为方向,-1:从光标向左,1:从光标向右,0:整行commit()将所有待处理的操作发送到关联的 stream 并清除待处理操作的内部列表。
事件:
line当 input 流接收到换行符(\n、\r 或 \r\n)时触发,通常在用户按下 Enter 键或 Return 键时触发close当 input 流接收到 Ctrl + C 或 Ctrl + D 时触发pause当 input 流被暂停时触发resume当 input 流恢复时触发history当历史数组发生更改时触发SIGCONT当之前使用 Ctrl+Z 移入后台的 Node.js 进程(即 SIGTSTP)随后使用 fg(1p) 返回前台时触发SIGINT当 input 流接收到 Ctrl + C 时触发,如果在 input 流接收到 SIGINT 时没有注册该事件监听器,则触发 pause 事件。SIGTSTP当 input 流接收到 Ctrl + Z 时触发,如果 input 流接收到 SIGTSTP 时没有注册该事件监听器,则 Node.js 进程将被发送到后台。
const readline = require('readline');const rl = readline.createInterface({ input: process.stdin, // 设置输入流 output: process.stdout, // 设置输出流});rl.question('今天星期几:', (answer) => { // 对答案进行处理 console.log(`答:${answer}`); rl.close();});const readline = require('readline');const rl = readline.createInterface({ input: process.stdin, output: process.stdout, prompt: '> ',});rl.prompt();rl.on('line', (line) => { console.log(`你输入了:${line}`); rl.prompt();}).on('close', () => { rl.clearLine(0); console.log('再见'); process.exit(0);});当然还有 promise 版本的 readline
const readline = require('readline/promises')const rl = readline.createInterface({ input: process.stdin, output: process.stdout})rl.question('今天星期几:').then(answer => { console.log(`答:${answer}`) rl.close()})环境变量env
process.env 用于读取操作系统所有的环境变量,也可以**修改(只在当前线程生效)**和查询环境变量
console.log(process.env)// { ALLUSERSPROFILE: 'C:\\ProgramData'......console.log(process.env.NVM_HOME)**区分开发与生产环境:**使用cross-env库设置环境变量
"scripts": { "dev": "cross-env NODE_ENV=dev node env.js", "build": "cross-env NODE_ENV=prod node env.js"},if (process.env.NODE_ENV === 'dev') { console.log('开发环境')} else if (process.env.NODE_ENV === 'prod') { console.log('生产环境')} else { console.log('未知环境')}cross-env 底层调用了不同系统的设置环境变量的命令
set NODE_ENV=prod #windowsexport NODE_ENV=prod #posix还可以使用dotenv库,从.env文件加载环境变量到process.env,配合cross-env更好的区分开发和生产环境的环境变量
child_process
使用child_process模块可以很方便地创建子进程,而且子进程之间可以通过事件消息系统进行互相通信
Node.js的进程管理 Node Guidebook 子进程 你应该了解的Node child_process
一个CPU一个进程不足以处理庞大的I/O工作(从网络读取、访问数据库或文件系统) 。无论服务器多么强大,一个线程仅仅能够支持有限的处理能力。 Node运行模式虽然是单线程,但是同样可以利用多个进程,当然也能使用集群。Node设计的初衷也是利用多个节点构建分布式应用程序。
在任何子进程中,都能做的事(非常适合处理Cpu密集型工作):
- 可以通过执行系统命令去访问控制操作系统
- 可以控制子进程的输入流,监听子进程的输出流
- 可以控制传给底层操作系统命令的参数
- 可以使用命令做任何事情
子进程的应用场景:
- 计算密集型应用
- 前端构建工具利用多核 CPU 并行计算,提升构建效率
- 进程管理工具,如:PM2 中部分功能
child_process提供了三个同步(Sync)方法和四个异步方法来创建子进程
exec、execSync执行命令,适用于小量数据,maxBuffer 默认值为1mb,超出会报错spawn、spawnSync执行命令,适用于返回大量数据,例如图像处理,二进制数据处理execFile、execFileSync执行可执行文件fork创建node子进程,每个进程之间是相互独立的,都有自己的V8实例、内存,通常根据CPU核心数设置- exec底层通过execFile实现,而execFile底层通过spawn实现
在Node标准库中,方法末尾加上Sync就是异步方法的同步版本,返回Buffer,而异步方法的回调首个参数都是err
exec
exec方法将会生成一个子shell,然后在该 shell 中执行命令
子进程会并缓冲产生的数据,当子进程结束后,exec会从子进程中返回一个完整的buffer
exec只适合获取小量数据,maxBuffer 默认值为1mb,超出会报错:Error:maxBuffer exceeded
child_process.exec(command, [options], callback)exec( command: string, options?: Object | undefined callback?: (( error: ExecException | null, stdout: string, stderr: string ) => void ) | undefined): ChildProcessoptions配置项:
cwd <string> 子进程的当前工作目录。env <Object> 环境变量键值对。encoding <string> 默认为 'utf8'。shell <string> 用于执行命令的 shell。 在 UNIX 上默认为 '/bin/sh',在 Windows 上默认为 process.env.ComSpec。timeout <number> 超时,默认为 0。maxBuffer <number> stdout 或 stderr 允许的最大字节数。默认为 1024 * 1024。如果超过限制,则子进程会被终止。查看警告:maxBuffer and Unicode。killSignal <string> | <integer> 默认为 'SIGTERM'。uid <number> 设置该进程的用户标识。gid <number> 设置该进程的组标识。windowsHide <boolean> 隐藏通常在 Windows 系统上创建的子进程控制台窗口。默认值:false。举个栗子:
exec('node -v && mkdir test',{ cwd: __dirname, // 设置工作目录为当前目录}, (err, stdout, stderr) => { console.log(stdout) // v18.12.1})通常用exec同步方法较多,因为处理的数据较少,速度快
const nodeVersion = execSync('node -v && mkdir test',{ cwd: __dirname, // 设置工作目录为当前目录})console.log(nodeVersion.toString())总之 shell 命令能做的,exec都能做
spawn
spawn创建一个子进程,具有三个输入输出流:stdin、stdout、stderr,通过这三个流,可以实时获取子进程的输入输出和错误信息
child_process.spawn(command, [args], [options])spawn( command: string, args?: readonly string[] | undefined, options?: SpawnOptionsWithoutStdio | undefined): ChildProcessWithoutNullStreamsoptions配置项:
cwd <string> | <URL> 子进程的当前工作目录。env <Object> 环境变量键值对。默认值:process.env。argv0 <string> 显式设置发送给子进程的 argv[0] 的值。如果未指定,这将设置为 command。stdio <Array> | <string> 子进程的标准输入输出配置。detached <boolean> 准备子进程独立于其父进程运行。具体行为取决于平台。uid <number> 设置进程的用户标识。gid <number> 设置进程的群组标识。serialization <string> 指定用于在进程之间发送消息的序列化类型。可能的值为 'json' 和 'advanced'。默认值:'json'。shell <boolean> | <string> 如果是 true,则在 shell 内运行 command。在 Unix 上使用 '/bin/sh',在 Windows 上使用 process.env.ComSpec。 可以将不同的 shell 指定为字符串。默认值: false(无外壳)。windowsVerbatimArguments <boolean> 在 Windows 上不为参数加上引号或转义。 在 Unix 上被忽略。当指定了 shell 并且是 CMD 时,则自动设置为 true。 默认值:false。windowsHide <boolean> 隐藏通常在 Windows 系统上创建的子进程控制台窗口。默认值:false。signal <AbortSignal> 允许使用中止信号中止子进程。timeout <number> 允许进程运行的最长时间(以毫秒为单位)。默认值:undefined。killSignal <string> | <integer> 当衍生的进程将被超时或中止信号杀死时要使用的信号值。默认值:'SIGTERM'。创建一个进程执行ping命令
const subprocess = spawn('ping', ['127.0.0.1'], { shell: true,})子进程流事件
监听子进程上的stdout流的事件,可以获取命令行的实时的输出数据
// 读取输出流subprocess.stdout.on('data', (data) => { console.log(iconv.decode(data, 'cp936'))})// 输出流结束subprocess.stdout.on('end', () => { console.log('end')})// 输出流关闭subprocess.stdout.on('close', () => { console.log('close')})// 正在 Ping 127.0.0.1 具有 32 字节的数据:// 来自 127.0.0.1 的回复: 字节=32 时间<1ms TTL=128// 来自 127.0.0.1 的回复: 字节=32 时间<1ms TTL=128// 来自 127.0.0.1 的回复: 字节=32 时间<1ms TTL=128// 来自 127.0.0.1 的回复: 字节=32 时间<1ms TTL=128// 127.0.0.1 的 Ping 统计信息:// 数据包: 已发送 = 4,已接收 = 4,丢失 = 0 (0% 丢失),// 往返行程的估计时间(以毫秒为单位):// 最短 = 0ms,最长 = 0ms,平均 = 0ms// end// close子进程事件
ChildProcess类继承EventEmitters所以实例包括以下几种事件
spawn一旦子进程成功生成,就会触发spawn事件。如果子进程没有成功生成,则触发error事件。无论生成的进程是否发生错误(如shell命令出错),spawn事件都会触发。exit该事件在子进程结束后触发。回调接收code、signal两个参数。如果进程退出,则 code 为进程最终退出码,否则为 null。 如果进程因收到信号而终止,则 signal 是信号的字符串名称,否则为 null,二者必有一null。close该事件在子进程结束并且其的标准输入输出流已关闭后触发。进程结束,流可能还未关闭。回调接收code、signal两个参数。disconnect调用父或子进程的disconnect()断开连接后触发。断开连接后就不能再发送或接收消息,且 subprocess.connected 属性为 false。error在无法衍生该进程,或进程无法终止,或向子进程发送消息失败,该事件就会被触发。发生错误后,exit事件可能会也可能不会触发。在监听 exit 和 error 事件时,应该注意防止多次意外调用回调函数。message当子进程使用send()发送消息时触发 message 事件。这是父子进程相互通信的基础。
通常child_process.spawn创建的子进程,只使用spawn、exit、close、error这四个事件,disconnect、message则在child_process.fork中使用
// 子进程创建成功subprocess.on('spawn', () => { console.log('subprocess spawn', subprocess.pid) // spawn 39036})setTimeout(() => { // 关闭子进程的标准输出流 subprocess.stdout.end(); // 退出子进程 subprocess.kill();}, 2000)// 子进程结束并退出subprocess.on('exit', (code, signal) => { console.log('subprocess exit', code, signal) // subprocess exit null SIGTERM})// 子进程结束并且其的标准输入输出流已关闭subprocess.on('close', (code, signal) => { console.log('subprocess close', code, signal) // subprocess close null SIGTERM})// 子进程错误subprocess.on('error', (err) => { console.log('subprocess error', err)})// 断开连接subprocess.on('disconnect', () => { console.log('subprocess disconnect')})// 子进程消息subprocess.on('subprocess message', (msg) => { console.log(msg)})execFile
execFile用于执行可执行文件,通常使用异步版本。
可执行文件:node脚本,shell文件,windows的cmd脚本,posix的sh脚本。
execFile默认不衍生shell,而是指定的可执行文件file直接作为新进程衍生,因此不支持 I/O 重定向和文件通配等行为,比exec()效率略高。
child_process.execFile(file[, args][, options][, callback])execFile( file: string, args: readonly string[] | null | undefined, options: Object | undefined callback: ( error: ExecFileException | null, stdout: string, stderr: string ) => void): ChildProcessoptions配置项:
cwd <string> | <URL> 子进程的当前工作目录。env <Object> 环境变量键值对。默认值:process.env。encoding <string> 默认值:'utf8'timeout <number> 默认值:0maxBuffer <number> 标准输出或标准错误上允许的最大数据量(以字节为单位)。如果超过,则子进程将终止并截断任何输出。默认值:1024 * 1024。killSignal <string> | <integer> 默认值:'SIGTERM'uid <number> 设置进程的用户标识。gid <number> 设置进程的群组标识。windowsHide <boolean> 隐藏通常在 Windows 系统上创建的子进程控制台窗口。默认值: false。windowsVerbatimArguments <boolean> 在 Windows 上不为参数加上引号或转义。在 Unix 上被忽略。默认值:false。shell <boolean> | <string> 如果是 true,则在 shell 内运行 command。在 Unix 上使用 '/bin/sh',在 Windows 上使用 process.env.ComSpec。 可以将不同的 shell 指定为字符串。默认值:false(无外壳)。signal <AbortSignal> 允许使用中止信号中止子进程。举个栗子:
execFile('node', ['-v'], (err, stdout, stderr) => { console.log(stdout) // v21.2.0});创建一个cmd文件
echo '开始'mkdir testcd ./testecho console.log("test") >test.jsecho '结束'node test.jsexecFile调用执行
execFile(path.resolve(__dirname, './test.cmd'),{ cwd: __dirname, // 设置工作目录为当前目录}, (err, stdout, stderr) => { console.log(stdout)});输出:
c:\chuckle\qx\NodeJS-new\child_process>echo '开始''开始'c:\chuckle\qx\NodeJS-new\child_process>mkdir testc:\chuckle\qx\NodeJS-new\child_process>cd ./testc:\chuckle\qx\NodeJS-new\child_process\test>echo console.log("test") 1>test.jsc:\chuckle\qx\NodeJS-new\child_process\test>echo '结束''结束'c:\chuckle\qx\NodeJS-new\child_process\test>node test.jstestfork
fork 用于衍生新的 Node.js 进程,会产生一个新的 V8 实例,所以需要指定一个 JS 文件,底层也是调用 spawn 来创建子进程
child_process.fork(modulePath[, args][, options])fork( modulePath: string, options?: ForkOptions | undefined): ChildProcessoptions配置项:
cwd <string> | <URL> 子进程的当前工作目录。detached <boolean> 准备子进程独立于其父进程运行。具体行为取决于平台。env <Object> 环境变量键值对。默认值:process.env。execPath <string> 用于创建子进程的可执行文件。execArgv <string[]> 传给可执行文件的字符串参数列表。默认值:process.execArgv。gid <number> 设置进程的群组标识。serialization <string> 指定用于在进程之间发送消息的序列化类型。可能的值为 'json' 和 'advanced'。默认值:'json'。signal <AbortSignal> 允许使用中止信号关闭子进程。killSignal <string> | <integer> 当衍生的进程将被超时或中止信号杀死时要使用的信号值。 默认值:'SIGTERM'。silent <boolean> 如果为 true,则子进程的标准输入、标准输出和标准错误将通过管道传输到父进程,否则它们将从父进程继承。参阅 child_process.spawn() 的 stdio 的 'pipe' 和 'inherit' 选项,默认值:false。stdio <Array> | <string> 参见 child_process.spawn() 的 stdio。提供此选项时,它会覆盖 silent。如果使用数组变体,则它必须恰好包含一个值为 'ipc' 的条目,否则将抛出错误。例如 [0, 1, 2, 'ipc']。uid <number> 设置进程的用户标识。windowsVerbatimArguments <boolean> 在 Windows 上不为参数加上引号或转义。在 Unix 上被忽略。默认值:false。timeout <number> 允许进程运行的最长时间(以毫秒为单位)。默认值:undefined。举个栗子:
// 使用child.js创建Node子进程const forked = fork(path.resolve(__dirname, './child.js'));
// 监听子进程的消息forked.on("message", msg => {  console.log("Message from child", msg);});
// 向子进程发送消息forked.send({ hello: "world" });
// 监听父进程发送的消息process.on("message", msg => { console.log("Message from parent:", msg);});
let counter = 0;
setInterval(() => { // 向父进程发送消息 process.send({ counter: counter++ });}, 1000);Message from parent: { hello: 'world' }Message from child { counter: 0 }Message from child { counter: 1 }Message from child { counter: 2 }# ......父子进程的通信:
- 父进程指定一个JS文件作为Node子进程,并获取子进程对象
- 父进程通过子进程对象,调用on()方法监听子进程发来的消息(触发message事件),调用send()方法向子进程发送消息
- 子进程调用process.send()方法向父进程发送消息
- 子进程监听message事件获取父进程发来的消息
通过 fork 创建子进程之后,父子进程之间会创建一个 IPC(进程间)通道,方便父子进程直接通信,在 JS 层使用 process.send(mes) 和 process.on('message', msg => {}) 。
在底层,实现进程间通信的方式有很多,Node 的IPC基于 libuv 实现,不同操作系统实现方式不一致,在 posix 中采用 Unix Domain Socket(套接字),Windows 中使用 name pipe(命名管道)。
常见进程间通信方式:消息队列、共享内存、pipe、信号量、套接字
更实际的案例
多个请求同时到来,并且都需要做大量计算
const server = (data) => { // 开启一个子进程,完成计算任务 const compute = fork(path.resolve(__dirname, './compute.js')); // 向子进程发送数据 compute.send(data); // 监听子进程的消息,获取计算结果 compute.on('message', (msg) => { console.log('计算结果:', msg); })}// 模拟多个请求同时到来server([1,2,3,4,5,6,7,8,9,10]);server([100,200,300,400,500,600,700,800,900,1000]);server([10,200,3000,4000,5000,6000,7000,8000,9000,10000]);const longComputation = async (data) => { return await new Promise((resolve, reject) => { setTimeout(() => { const sum = data.reduce((a, b) => { return a + b; }, 0); resolve(sum); }, 3000); // 模拟3s的计算任务 });};// 监听父进程发送的消息,开启计算任务process.on("message", async msg => { try { const result = await longComputation(msg); // 等待计算任务完成后,向父进程发送结果 process.send(result); } catch (error) { process.send({ error: error.message }); } finally { process.disconnect(); process.exit(); }});3s后,3个计算任务同时完成,主进程输出结果
计算结果: 55计算结果: 5500计算结果: 52210上面的代码受 fork 的进程数量限制,但是当我们执行它并通过 http 请求耗时计算端点时,主服务器没有被阻塞并且可以接受进一步的请求
Node的cluster模块就是基于这种思想。
ffmpeg
ffmpeg(cn)是一个开源的跨平台多媒体处理工具,它功能强大,用途广泛,大量用于视频网站和商业软件,也是许多音频和视频格式的标准编码/解码实现
它提供了一组强大的命令行工具和库,可以进行格式转换、视频处理、音频处理、流媒体传输等操作
先封装一个通过execFile调用ffmpeg的函数
const ffmpeg = (str) => { const ffmpegProcess = childProcess.execFile('ffmpeg', str.split(" "), { cwd: __dirname, }, (err, stdout, stderr) => { if (err) { console.error(err) return } console.log("ffmpeg执行成功") }) ffmpegProcess.stdin.write('y'); // 输入y,覆盖输出文件 ffmpegProcess.stdin.end(); // 结束输入流}调用函数传入参数实现功能
// 格式转换ffmpeg('-i ./test.mp4 ./test.avi')
// 音频提取,直接转为音频格式即可,-vn表示去掉视频ffmpeg('-i ./test.mp4 -vn ./test.mp3')
// 裁剪视频,内部的编码格式不变,所以使用-c copy指定直接拷贝,不经过转码,这样比较快ffmpeg('-i ./test.mp4 -ss 00:00:00 -to 00:00:05 -c copy ./test2.mp4')
// 加水印ffmpeg('-i ./test.mp4 -vf drawtext=text=Chuckle:fontsize=30:fontcolor=white:x=10:y=10 ./test3.mp4')
// 删除水印,指定水印宽高和起始点ffmpeg('-i ./test3.mp4 -vf delogo=w=120:h=30:x=10:y=10 ./test4.mp4')
评论